Google Research претстави пристап во кој јазичните модели менуваат активна работа со фази за зацврстување на наученото. Целта е новите знаења да се задржат без да се потиснат старите.
Вештачката интелигенција може брзо да одговори на прашање, но задржувањето на новото знаење е посложен проблем. Google Research на 27 октомври претстави пристап наречен „sleep framework“, во кој јазичниот модел периодично преминува од активна работа во фаза за обработка на наученото.
Идејата е инспирирана од зацврстувањето на човечките сеќавања за време на одмор. Кај компјутерскиот систем, сепак, „спиењето“ е име за пресметковен процес, со архитектура и правила што ги определуваат истражувачите.
Зошто новото знаење може да го потисне старото?
Според објаснувањето на Google, дополнителното обучување може да предизвика „катастрофално заборавање“: моделот станува подобар во новата задача, а послаб во претходно совладаните. Информациите внесени само во разговорот, пак, се ограничени од неговиот контекст.
Предложеното решение ги разделува активната фаза и фазата на „спиење“. Во првата моделот обработува нови влезни информации; во втората ги насочува пресметките кон нивно зацврстување.
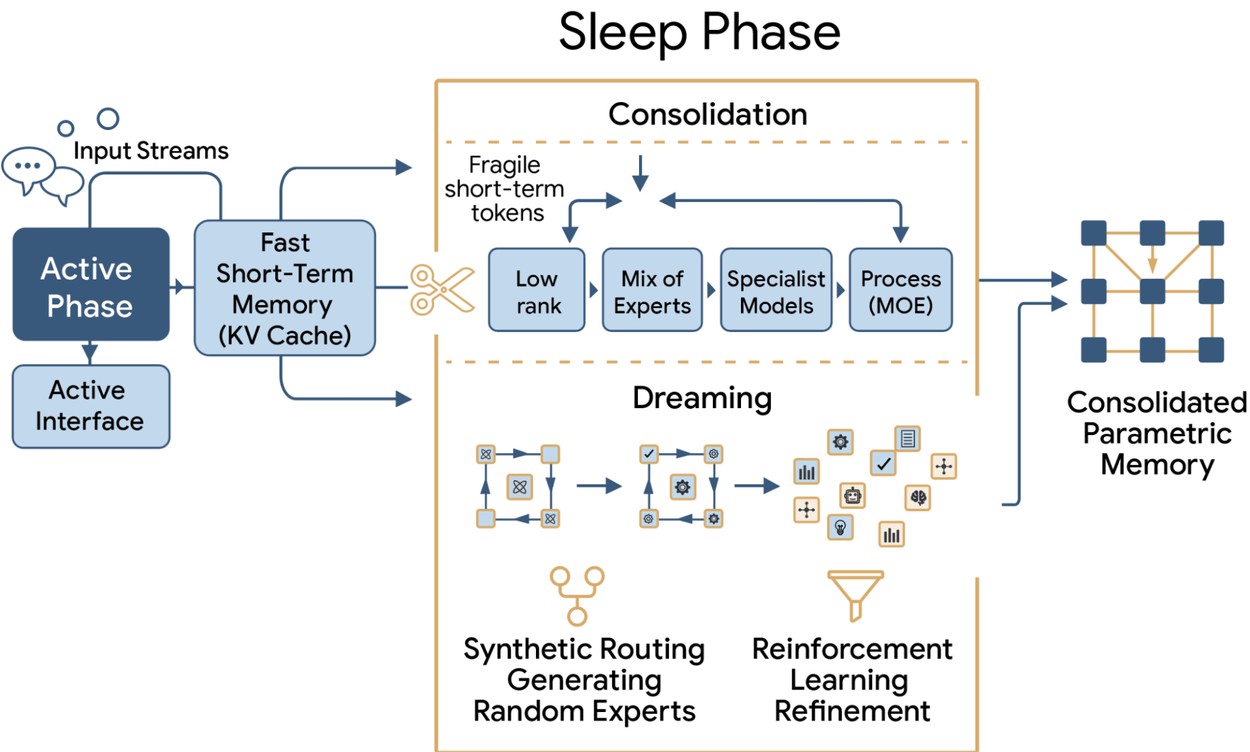
Шема на фазите за обработка и зацврстување на информациите. Илустрација: Google Research.
Од краткотраен контекст до потрајно паметење
Научниот труд „Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories“ го разработува пренесувањето на привремените информации во долгорочни параметри на моделот. Наместо секоја промена да ги препишува старите знаења, пристапот користи дополнителни мемориски компоненти и нивно постепено вклучување.
Посебен дел е наречен „сонување“. Моделот создава синтетички примери за вежбање, а избраните примери се користат за натамошно усовршување. Тоа е технички назив за постапката на обучување.
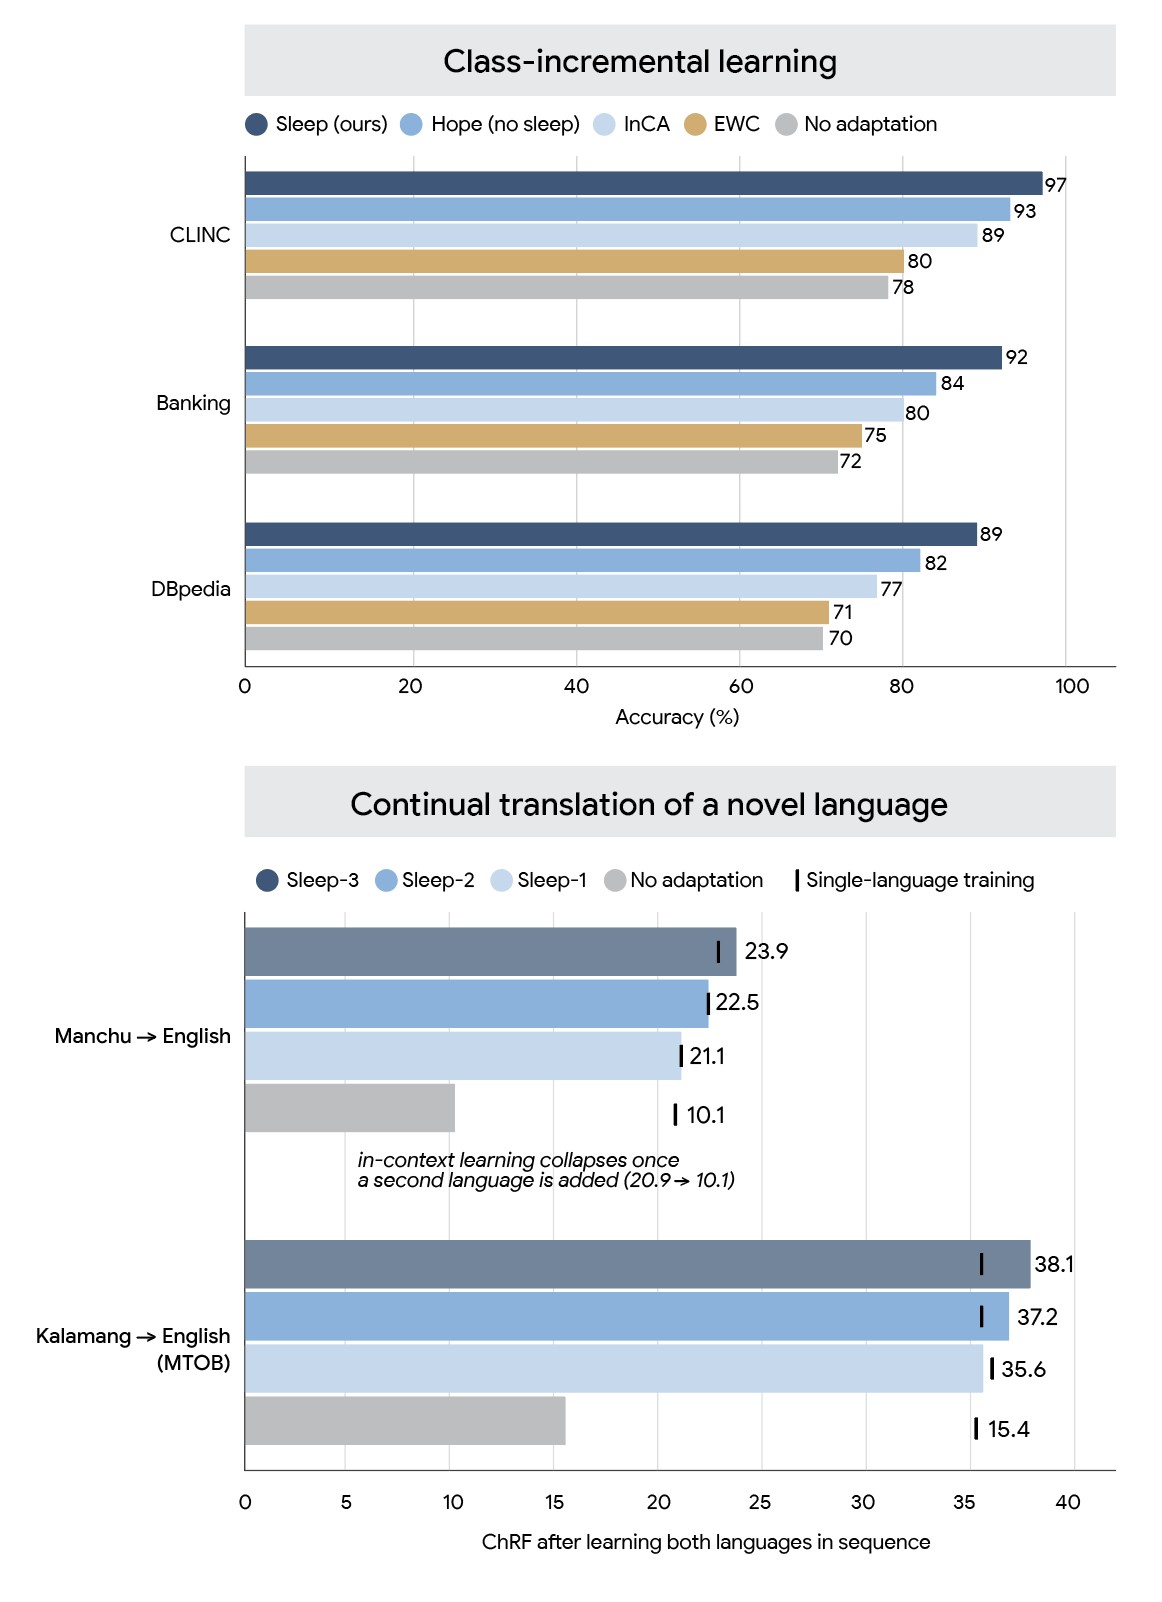
Резултати од експериментите што ги прикажуваат авторите на истражувањето. Графикон: Google Research.
Што всушност покажува истражувањето?
Авторите пријавуваат подобрувања во експерименти со задржување факти, последователно учење и расудување. Резултатите се однесуваат на испитуваните модели и задачи и треба да се читаат во тој опсег.
Станува збор за истражувачки пристап, без најава дека секојдневните корисници веќе добиле универзална функција за трајно AI-паметење. Неговата вредност е во обидот да одговори на конкретно прашање: како системот да продолжи да учи, а да го зачува она што веќе го знае?
Насловна илустрација: Google Research.